Разбор на примере симуляции баллистических траекторий в Python через NumPy и CuPy
Коротко: я взял прикладную инженерную задачу — массовый расчёт 2D-траекторий с сопротивлением воздуха — и сравнил обычный NumPy-расчёт на CPU с вариантом на GPU через CuPy RawKernel.
Главный результат: на арендованной RTX 5090 вариант CuPy RawKernel device-resident показал ускорение примерно в 3771 раз относительно NumPy CPU. Даже режим including transfer, где учитывается копирование данных между CPU и GPU, оказался быстрее CPU примерно в 1863 раза.
Отдельное внимание уделено тому, как расчёт был переписан под логику видеокарты и зачем использовать RawKernel.
Меня зовут Владимир. Я — часть команды GPUGO, занимаюсь продвижением сервиса. В этой статье на практическом примере разберу, как GPU может ускорять инженерные численные расчёты на примере с моделированием большого числа траекторий. Для эксперимента я использовал арендованную на gpugo.ru RTX 5090 и сравнил обычный расчёт на CPU через NumPy с реализацией на GPU через CuPy RawKernel. Внутри — совсем немного математики, кода, практические замеры, сравнение реализаций с учётом передачи данных CPU-GPU и без. Поскольку основная моя деятельность связана с решением и реализацией подобных задач численными методами, тема представленного материала — это область моего непосредственного интереса.
Главная цель статьи — на наглядном примере показать, почему параллельные вычисления хорошо ложатся на видеокарту и в каких случаях это существенно сэкономит время получения решения и ускоряет расчеты в тысячи раз*.*
1. GPU в прикладных расчётах
В инженерных задачах часто встречается не один большой расчёт, а множество похожих независимых расчётов. Типичные примеры: метод Монте-Карло, перебор параметров, сеточные методы, массовое моделирование траекторий, оптимизация начальных условий.
Такая нагрузка хорошо ложится на личную или арендованную GPU, если выполняются три условия:
- Работы много: сотни тысяч или миллионы элементов.
- Операции однотипные.
- Данные можно держать в видеопамяти хотя бы на время серии вычислений.
Если хотя бы одно из условий не выполняется, CPU может оказаться быстрее — особенно когда NumPy уже делает тяжёлую часть в оптимизированном C-коде.
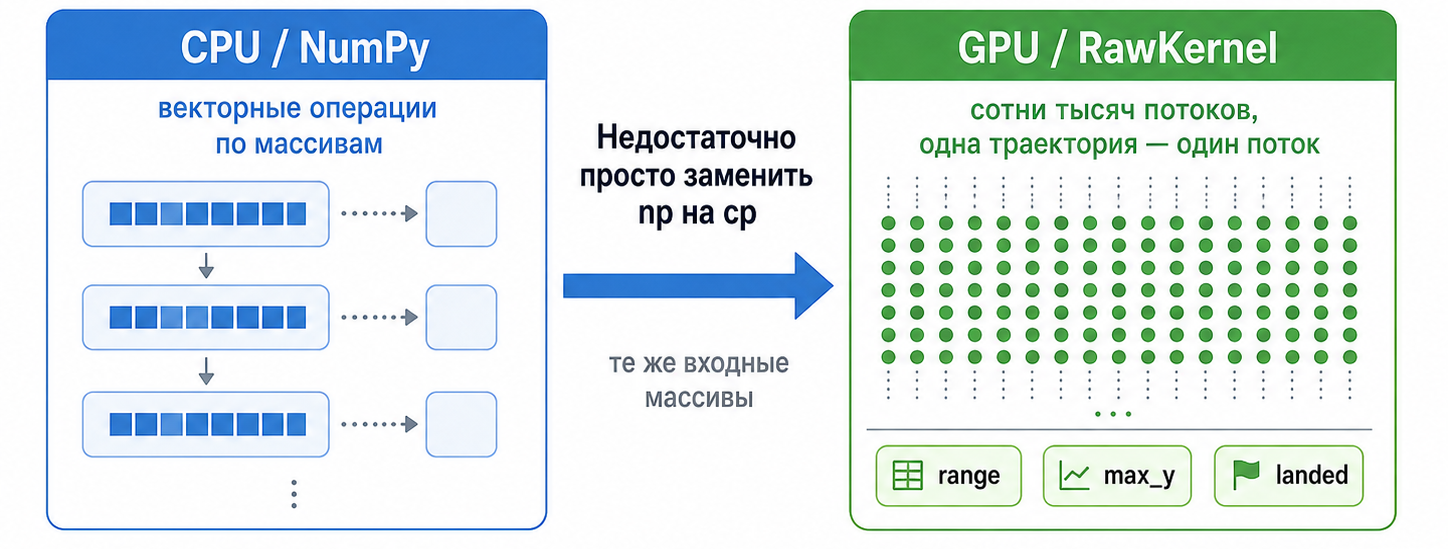
Рисунок 1. Перенос вычислений на GPU требует подходящей формы задачи, а не только замены np на cp.
| Подход | Плюсы | Ограничения |
|---|---|---|
| NumPy на CPU | • Простой код • Быстрые векторные операции • Обычно проще с окружением | • Цикл по времени остаётся на CPU • Создаются временные массивы |
| CuPy в векторах | • Синтаксис близок к NumPy • Легче портировать существующий код | • Много запусков ядер GPU • Накладные расходы могут съесть выигрыш |
| CuPy RawKernel | • Контроль над CUDA-ядром • Меньше лишних запусков и промежуточных операций | • Код сложнее • Нужно думать о форме вычислений |
Таблица 1. Три уровня реализации: удобство против контроля над производительностью.
2. Постановка задачи
В качестве демонстрационного примера выбрана простая, но хорошо масштабируемая задача: посчитать большое число независимых 2D-траекторий с сопротивлением воздуха. У каждой траектории свои начальная скорость, угол, масса, радиус, коэффициент сопротивления и горизонтальный ветер.
Это пока не попытка имитировать реальную внешнюю баллистику с высокой точностью. Цель другая: получить наглядную задачу, в которой есть массивы, миллионы однотипных шагов и очевидный смысл результата — дальность полёта и максимальная высота.
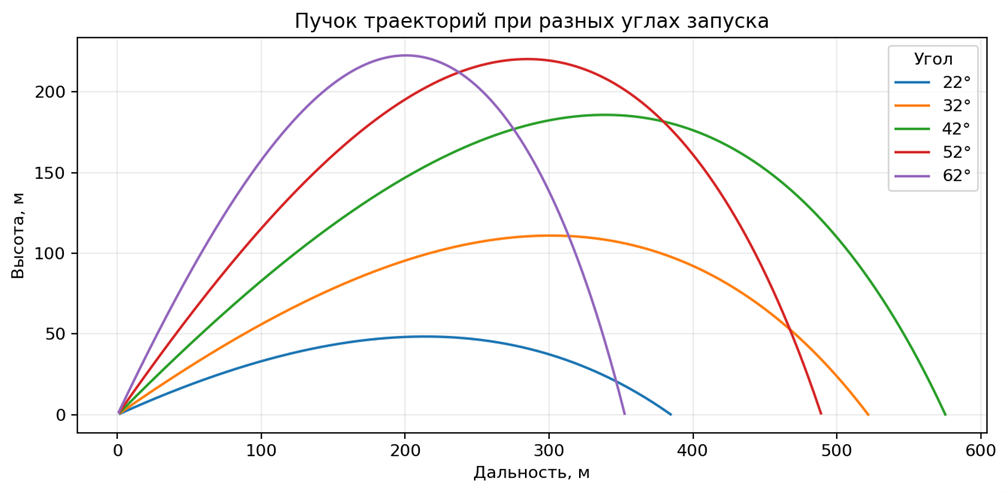
Рисунок 2. Пример пучка траекторий при разных углах запуска. В расчёте учитывается сопротивление воздуха.
| Параметр | Смысл | Диапазон в notebook |
|---|---|---|
| n_trajectories | число независимых траекторий | 800 000 по умолчанию |
| steps | число шагов интегрирования | 800 по умолчанию |
| dt (Delta t) | шаг времени | 0,015 с |
| v0 | начальная скорость | 40–160 м/с |
| Angle_deg | угол запуска | 15–75° |
| mass | масса объекта | 0,05–0,20 кг |
| r | радиус объекта | 0,015–0,045 м |
| Cd | коэффициент сопротивления | 0,25–0,75 |
| wind_x | горизонтальный ветер | −8…8 м/с |
Таблица 2. Основные параметры задачи.
3. Математическая модель
Состояние траектории хранится четырьмя величинами: координаты x, y и компоненты скорости vx, vy. Сопротивление воздуха зависит от скорости относительно воздуха, поэтому отдельно учитывается горизонтальный ветер.
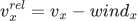

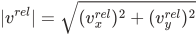
Коэффициент сопротивления на единицу массы:
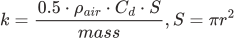
Ускорение с учётом сопротивления и гравитации:
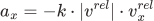
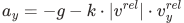
Интегрирование выполняется простым явным шагом:
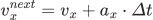
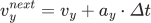
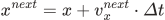
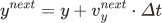
Когда y пересекает ноль, дальность уточняется линейной интерполяцией между двумя последними точками. Это уменьшает ошибку попадания в землю без уменьшения шага времени.
Эта модель намеренно сделана простой: цель была не построить полноценный CFD-расчёт, а получить физически осмысленную, хорошо параллелящуюся задачу для проверки GPU-ускорения.
4. Как я поднял среду на gpugo.ru
Отдельно отмечу инфраструктурную часть, потому что для прикладных расчётов она часто решает не меньше, чем сам код. Когда хочется быстро проверить гипотезу, установка драйверов, CUDA, CuPy и Jupyter может занять больше времени, чем первый эксперимент.
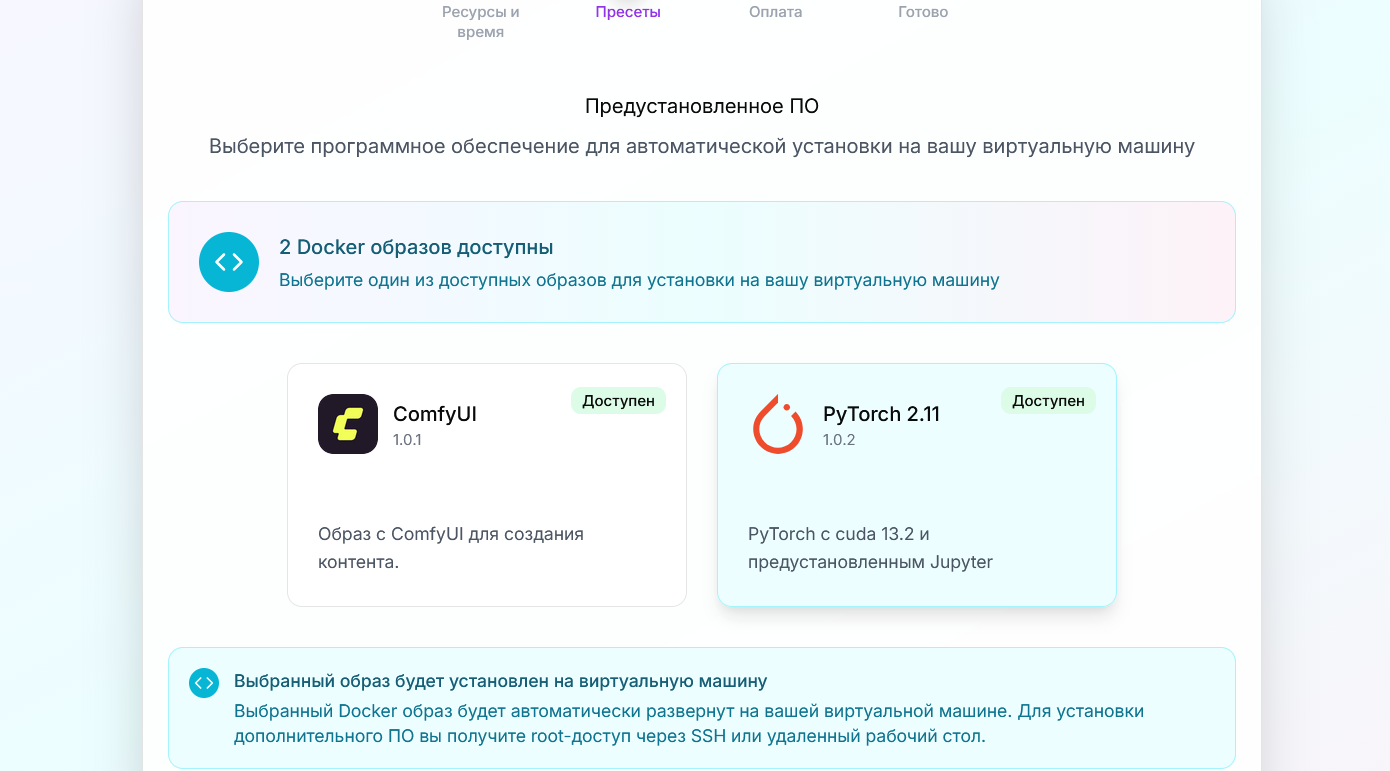
Рисунок 3. Готовые образы в GPUGO
В GPUGO я взял готовый шаблон с JupyterLab и уже настроенным окружением для CUDA/CuPy. В моём запуске путь от выбора GPU-машины до открытого JupyterLab занял 7 минут. Код в файле .ipynb был подготовлен заранее: я вне аренды написал ячейки с моделью, проверками и замерами, а на машине только подгрузил недостающие библиотеки, открыл файл и запустил расчёт.
Повторный запуск получился ещё проще: открыть JupyterLab, прогнать основные замеры и получить таблицы — меньше 2 минут. Рекомендуется выгружать результаты из рабочей среды до окончания оплаченной сессии, но данные не сгорают ещё 12 часов. Для меня это оказалось удобным: меньше времени на настройку окружения и загрузку-выгрузку данных + меньше денег за аренду в простое.
5. Реализация: от NumPy к CuPy RawKernel
5.1. CPU baseline
CPU-вариант реализован через NumPy. Он векторизован по траекториям, но цикл по времени остаётся в Python. На каждом шаге создаются временные массивы: относительная скорость, модуль скорости, ускорение, новые координаты и маски приземления.
for step in range(cfg.steps):
    vrel_x = vx - wind_x
    speed_rel = np.sqrt(vrel_x * vrel_x + vy * vy + eps)
    ax = -drag_over_mass * speed_rel * vrel_x
    ay = -g - drag_over_mass * speed_rel * vy
    vx_new = vx + ax * dt
    vy_new = vy + ay * dt
    x_new = x + vx_new * dt
    y_new = y + vy_new * dt
5.2. Почему простая замена NumPy на CuPy не гарантирует ускорение
CuPy удобен тем, что его синтаксис практически идентичен NumPy. Но векторизованный CuPy-код может запускать отдельное GPU-ядро почти на каждую крупную операцию. Если таких операций много, и они выполняются внутри цикла по времени, зти запуски становятся заметными.
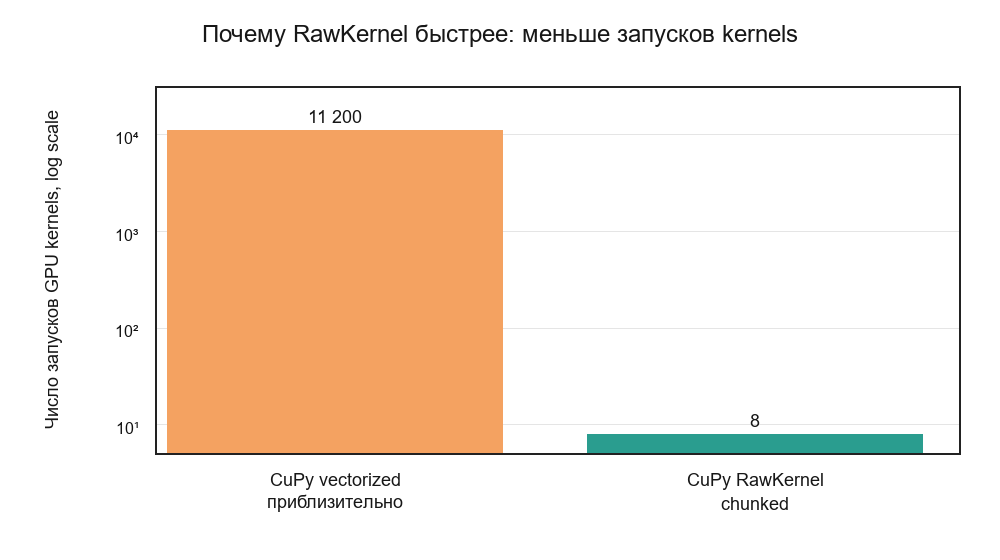
Рисунок 4. При 800 шагах времени vectorized CuPy может дать тысячи запусков, а chunked RawKernel — считанные запуски.
Первый эксперимент как раз показал этот эффект: векторизованный CuPy оказался медленнее CPU NumPy на выбранном размере задачи. Это не ошибка GPU; это ошибка формы вычислений.
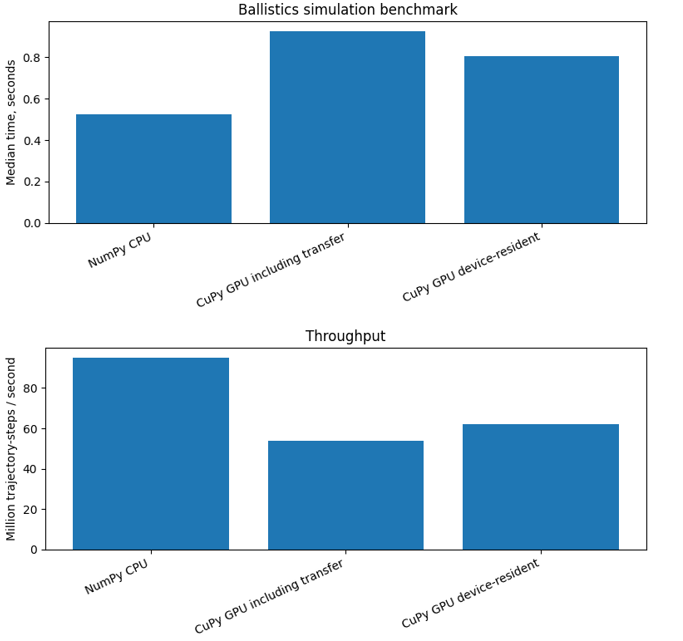
Рисунок 5. Первый вариант: CuPy vectorized проигрывает NumPy CPU из-за overhead запусков и копирования данных.
5.3. Самый эффективный GPU вариант: RawKernel
В оптимизированной версии один CUDA- поток считает одну траекторию. Внутри потока локально хранятся x, y, vx, vy (координаты и скорости), а несколько шагов по времени выполняются внутри одного запуска ядра. Такой подход уменьшает количество запусков GPU-ядер и лучше загружает видеокарту.
extern "C" __global__
void ballistic_chunk_kernel(..., const int steps_this_launch) {
    int idx = blockDim.x * blockIdx.x + threadIdx.x;
    if (idx >= n || landed[idx] != 0) return;
    float xi = x[idx];
    float yi = y[idx];
    float vxi = vx[idx];
    float vyi = vy[idx];
    for (int s = 0; s < steps_this_launch; ++s) {
        // сопротивление, гравитация, интегрирование, проверка земли
    }
    x[idx] = xi;
    y[idx] = yi;
    vx[idx] = vxi;
    vy[idx] = vyi;
}
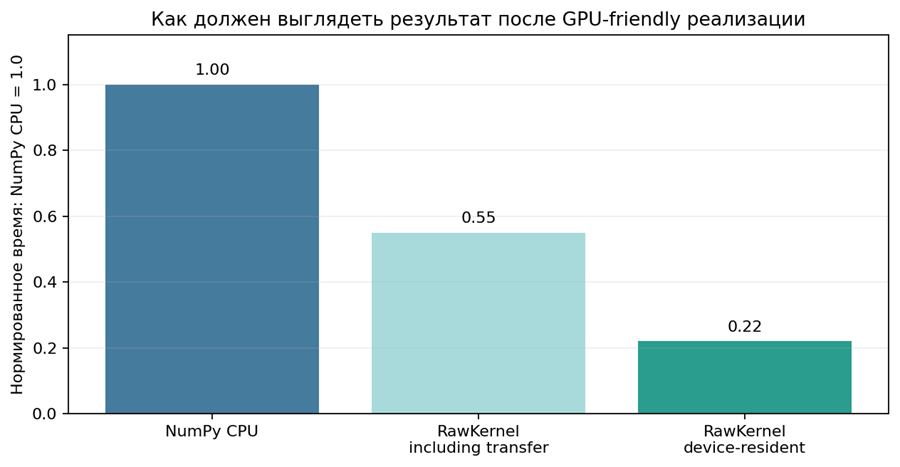
Рисунок 6. Схематичный ожидаемый профиль: главный выигрыш даёт RawKernel device-resident. Это не измеренные числа, а форма результата, к которой приводит оптимизация.
6. Методика бенчмарка и счётчики времени
Эксперимент дополнен индикаторами прогресса и расчётом ETA для долгих ячеек. Блок замеров отдельно выводит медианное, минимальное, максимальное и среднее время выполнения, суммарное время повторных запусков, время прогрева, реальное время выполнения (wall-clock time) всего бенчмарк-блока, пропускную способность и ускорение относительно базовой реализации на NumPy CPU.
| Колонка | Что означает |
|---|---|
| median_s | типичное время одного измеряемого запуска |
| min_s / max_s | лучший и худший повтор |
| mean_s / std_s | среднее и разброс по повторениям |
| total_repeat_time_s | суммарное время всех измеряемых повторений |
| total_warmup_time_s | суммарное время прогревочных запусков |
| million_trajectory_steps_per_s | сколько миллионов шагов траекторий считается в секунду |
| speedup_vs_numpy | ускорение относительно NumPy CPU |
Таблица 3. Метрики, которые выводит notebook.
Принципиально важно сравнивать два GPU-режима отдельно:
| Режим | Что включает | Когда использовать для вывода |
|---|---|---|
| including transfer | копирование CPU → GPU, расчёт, копирование GPU → CPU | для оценки полного end-to-end сценария |
| device-resident | данные уже лежат на GPU, измеряется в основном расчёт | для оценки реального потенциала GPU |
Таблица 4. Почему один и тот же GPU может показывать разные результаты.
7. Структура итогового ноутбука
Итоговый ноутбук состоит из следующих смысловых блоков:
| Блок | Содержимое |
|---|---|
| Диагностика окружения | проверка Python, CuPy, GPU, CUDA runtime,NVRTC |
| Progress bar | HTML-progress в Jupyter без внешнего tqdm |
| Физическая модель | параметры, формулы, интегрирование |
| NumPy baseline | векторизованный CPU-расчёт |
| CuPy RawKernel | GPU kernel с chunked-интегрированием |
| Smoke test | маленькая задача и проверка CPU/GPU совпадения |
| Benchmark | измерения CPU, GPU including transfer, GPU device-resident |
| Timing report | точные времена и throughput (успешно обработанные данные за единицу времени) |
| Автовывод | текстовое объяснение результатов по bench_df |
| Графики | время, throughput, speedup, распределение дальностей |
Таблица 5. Что входит в ноутбук.
7.1 Настройки размера задачи
| Цель | n_trajectories | steps | steps_per_kernel_launch |
|---|---|---|---|
| Быстрый дебаг | 50 000 | 400 | 50 |
| Нормальный GPU benchmark для RTX 5090 | 800 000 | 800 | 100 |
| Тяжёлый benchmark | 1 000 000 | 1000 | 100 |
Таблица 6. Настройки для разных режимов запуска.
Важная практическая деталь: если progress bar начинает заметно влиять на бенчмарк, его можно отключить через show_progress=False в benchmark_call. Для демонстрации и отладки он был бы полезен, но для финального замера лучше сделать отдельный запуск без лишнего вывода.
7.2 Нормализация метрик
Нормализация нужна, чтобы сравнивать методы не только в секундах, но и в относительных величинах. Так сразу видно, во сколько раз GPU быстрее или медленнее CPU, а также сколько стоит один миллион элементарных шагов моделирования.
speed_vs_cpu = t_CPU / t_method
time_vs_cpu  = t_method / t_CPU
ms_per_1M_steps = 1000 / throughput_Msteps_s
transfer_overhead = t_including_transfer - t_device_resident
8. Ключевые результаты
| Метод | Median time, s | Throughput, Msteps/s | Speed vs CPU | Time vs CPU | ms / 1M steps | Класс |
|---|---|---|---|---|---|---|
| CuPy RawKernel device-resident | 0.0031 | 205,989.6 | 3,771.42x | 0.0003x | 0.005 | faster than CPU |
| CuPy RawKernel including transfer | 0.0063 | 101,743.4 | 1,862.80x | 0.0005x | 0.010 | faster than CPU |
| NumPy CPU | 11.7176 | 54.6 | 1.00x | 1.000x | 18.309 | CPU |
Таблица 7. Результат на RTX 5090.
Примечание. CPU является baseline. Значение speed_vs_cpu больше 1 означает ускорение относительно CPU. Значение time_vs_cpu меньше 1 означает, что метод занимает меньшую долю CPU-времени.
8.1 Визуальное сравнение
Из-за большого разрыва между CPU и GPU графики построены в логарифмической шкале. Это не меняет сами значения, но делает столбцы читаемыми на одной диаграмме.
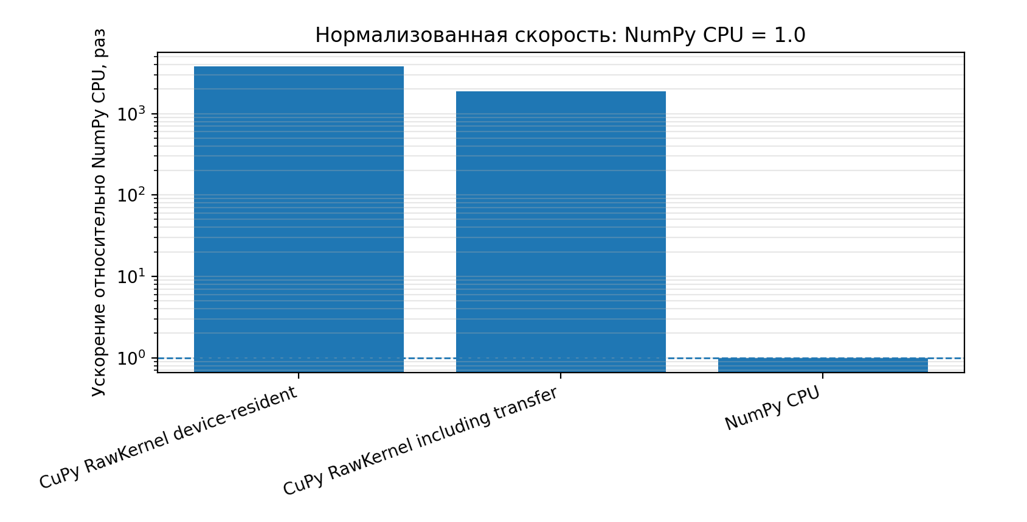
Рисунок 7. Ускорение относительно NumPy CPU: больше — лучше.
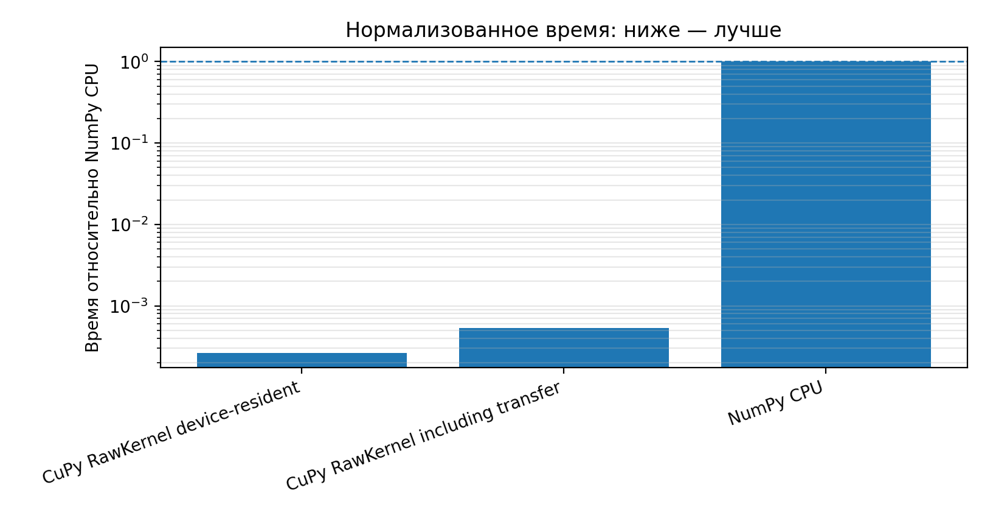
Рисунок 8. Время относительно NumPy CPU: ниже — лучше.
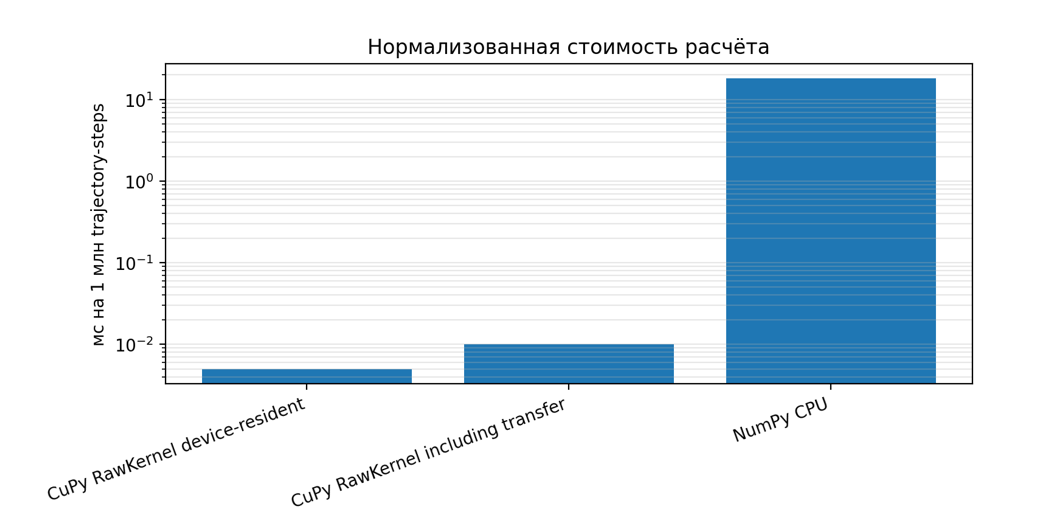
Рисунок 9. Стоимость расчёта одного миллиона trajectory-steps.
8.2 Transfer overhead
Режим including transfer включает не только само вычисление на GPU, но и копирование данных из оперативной памяти CPU в видеопамять GPU и обратно. Режим device-resident показывает вычисление, когда данные уже лежат в VRAM.
| Показатель | Значение |
|---|---|
| including transfer median time | 0.0063 s |
| device-resident median time | 0.0031 s |
| transfer overhead | ≈ 0.0032 s |
| доля overhead внутри including transfer | ≈ 50.6% |
| замедление including transfer относительно device-resident | ≈ 2.02x |
Таблица 8. Результаты transfer VS device-resident
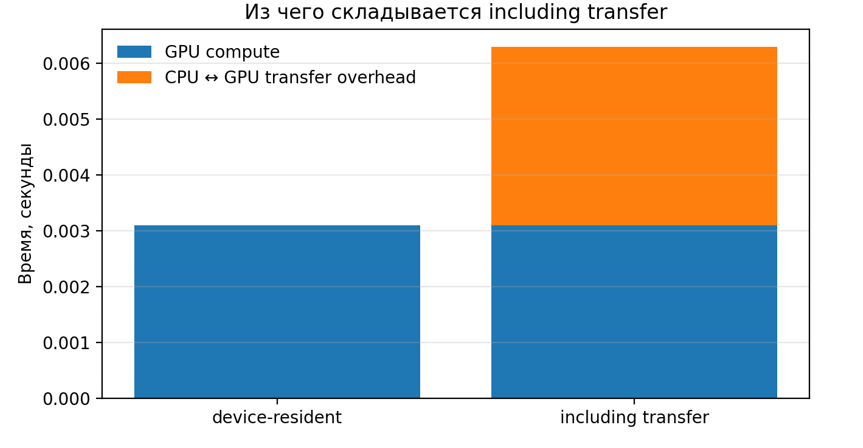
Рисунок 10. Including transfer примерно наполовину состоит из накладных расходов на передачу данных.
Практический вывод простой: если каждый запуск начинается с копирования данных на GPU и заканчивается копированием результата обратно на CPU, часть выигрыша по времени теряется. Если же расчёт состоит из цепочки GPU-этапов и данные можно держать в видеопамяти, device-resident сценарий показывает реальный потенциал GPU.
9. Где лучше CPU, а где GPU
Разрыв между CPU и GPU определяется не только железом. Важнее структура вычисления. NumPy CPU часто выигрывает на маленьких задачах, потому что накладные расходы минимальны, а операции внутри массивов уже оптимизированы. GPU начинает выигрывать, когда работы много, ядра крупные, а данные остаются на видеокарте.
| Фактор | Влияние на CPU | Влияние на GPU |
|---|---|---|
| Размер задачи | маленький размер выгоден CPU | большой размер нужен для загрузки GPU |
| Количество запусков kernels | не относится напрямую | много запусков убивают выигрыш |
| Копирование данных | данные уже в RAM | CPU ↔ GPU transfer может быть дорогим |
| Ветвления | CPU переносит ветвления нормально | ветвления внутри warp могут снижать эффективность |
| Долгий цикл по времени | Python-loop и временные массивы становятся дорогими | chunked RawKernel может считать цикл внутри CUDA |
Таблица 9. Почему не всякий GPU-код быстрее CPU.
По итогу можно сформулировать такое распредение:
| Сценарий | Лучший выбор | Почему |
|---|---|---|
| 10–50 тыс. траекторий, короткий расчёт | CPU / NumPy | меньше overhead, проще запуск |
| сотни тысяч траекторий и много шагов | GPU / RawKernel | много независимой работы |
| данные нужны на CPU после каждого шага | CPU или осторожный GPU | копирование может съесть выигрыш |
| данные остаются на GPU между этапами | GPU device-resident | нет лишнего трансфера |
| прототипирование физики | CPU / NumPy | проще отладка и печать промежуточных значений |
| финальный прогон параметрического исследования | GPU / RawKernel | лучше масштабируется |
Таблица 10. Практическое правило выбора CPU или GPU.
10. Вывод
- CuPy RawKernel device-resident показал ускорение в 3771.42 раз относительно NumPy CPU. Даже режим including transfer, где учитывается копирование CPU ↔ GPU, оказался быстрее CPU в 1862.8 раз. CuPy vectorized удобен для старта, но не всегда быстр: большое количество операций внутри цикла по времени может дать тысячи kernel launches. RawKernel позволяет упаковать вычисления в одно CUDA-ядро и считать несколько шагов по времени за запуск.
Код эксперимента: https://github.com/jetsedpack/ballistics_cupy_rawkernel_benchmark